hello算法之图
图
图是一种非线性数据结构,由顶点(vertex)和边(edge)构成
图的常见术语
根据图的边是否有方向来分类,可分为无向图(undirected graph)和有向图(directed graph)
- 在无向图中,边表示两顶点之间的“双向”连接关系,例如微信和QQ中的“好友关系”
- 在有向图中,边具有方向性,即A->B和A<-B两个方向都是互相独立的,例如微博或抖音上的“关注”与“被关注”关系
根据所有定点是否连通,可分为连通图(connected graph)和非连通图(disconnected graph)
- 对于连通图,从某个顶点出发,可以到达其余任意顶点
- 对于非连通图,从某顶点出发,至少有一个顶点无法到达
图数据结构常用术语如下:
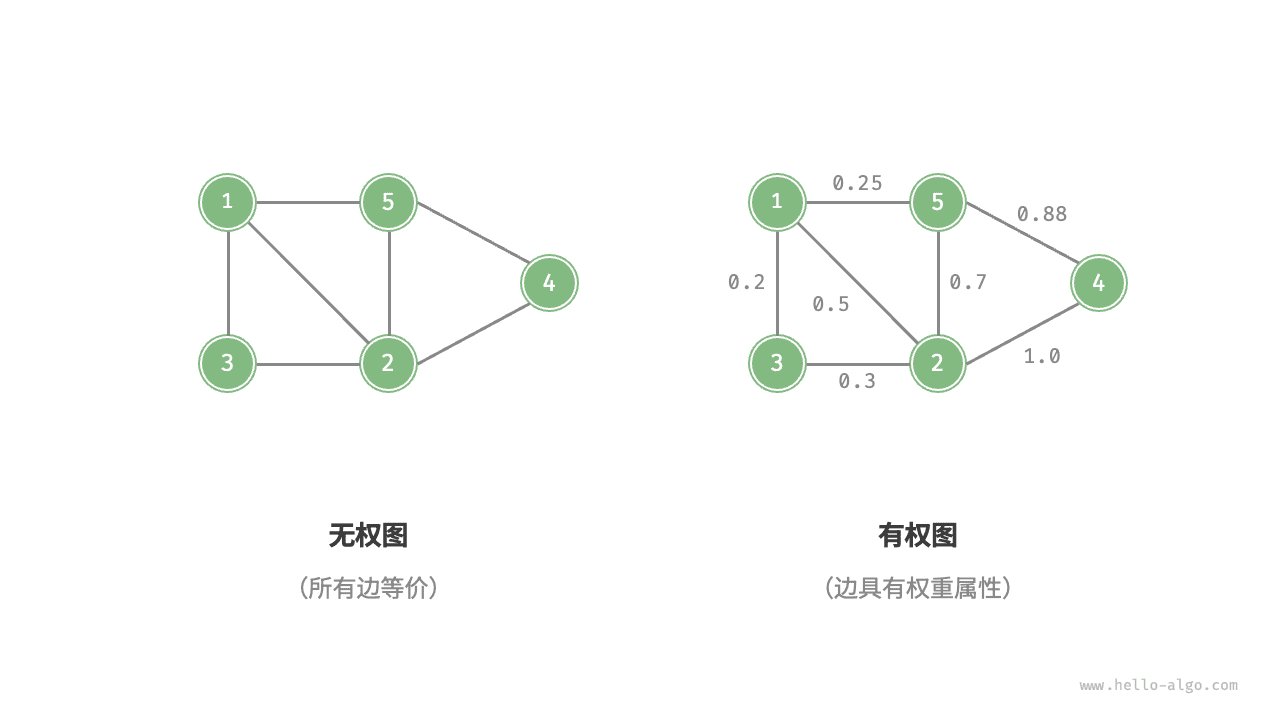
- 邻接(adjacency):当两顶点之间存在边相连接时,称这两顶点“邻接”。如下图所示,顶点1的邻接顶点为顶点2、3、5。
- 路径(path):从顶点A到顶点B经过的边构成的序列被称为从A到B的“路径”。在下图中,边序列1-5-2-4是顶点1到顶点4的一条路径。
- 度(degree):一个顶点拥有的边数。对于有向图,入度(in-degree)表示有多少条边指向该顶点,出度(out-degree)表示有多少条边从该顶点指出。
图的表示
图的常用操作表示方式包括“邻接矩阵”和“邻接表”。下面案例使用无向图进行举例。
1. 邻接矩阵
设图的顶点数量为n,邻接矩阵(adjacency matrix)使用一个n * n大小的矩阵来表示图,每一行(列)代表一个顶点,矩阵元素代表边,用1或0表示两个顶点之间是否存在边。
设邻接矩阵为M、顶点列表为V,那么矩阵元素M[i, j] = 1表示顶点V[i]到顶点V[j]之间存在边,反之M[i, j] = 0表示两顶点之间无边。
1 —— 2
 \
  3

邻接矩阵如下:
    1 2 3
1 [ 0 1 1 ]
2 [ 1 0 0 ]
3 [ 1 0 0 ]
邻接矩阵具有以下特性:
- 在简单图中,顶点不能与自身相连,此时邻接矩阵主对角线元素没有意义。
- 对于无向图,两个方向的边等价,此时邻接矩阵关于主对角线对称。
- 将邻接矩阵的元素从1和0替换权重,则可表示有权图。
使用邻接矩阵表示图时,我们可以直接根据需要获取的节点索引获取边,因此增删改查操作效率最高,时间复杂度均为O(1)。然而,矩阵的空间复杂度为O(n^2),因此内存占用比较多。
2.邻接表
邻接表(adjacency list)使用n个链表来表示图,链表节点表示顶点。第i个链表对应顶点i,其中存储了该顶点的所有邻接顶点(与该顶点相连的顶点)。
1 —— 5 —— 4
|  \ | /
3 —— 2

邻接表如下:
1 [ 2 3 5 ]
2 [ 1 3 5 4 ]
3 [ 1 2 ]
4 [ 2 5 ]
5 [ 1 2 4 ]
邻接表仅存储实际存在的边,而边的总数通常远小于n^2,因此它更加节省空间。然而,在邻接表中需要通过遍历链表来查找边,因此时间效率不如邻接矩阵。
邻接表结构与哈希表中的“链式地址”非常相似,因此我们也可以采用类似的方法来优化效率,比如当链表较长时,可以将链表转化为AVL树或红黑树,从而将时间效率从O(n)优化至O(log n);还可以把链表转换为哈希表,从而将时间复杂度降至O(1)。
图的操作
图的基础操作可分为“边”的操作和对“顶点”的操作。在“邻接矩阵”和“邻接表”两种表示方法下,实现方式有所不同。
基于邻接矩阵的实现
给定一个顶点数量为n的无向图,则各种操作的实现方式如下。
- 添加或删除边:直接在邻接矩阵中修改指定的边即可,使用O(1)时间。而由于是无向图,因此需要同时更新两个方向的边。
- 添加顶点:在邻接矩阵的尾部添加一行一列,并全部填0即可,使用O(n)时间。
- 删除顶点:在邻接矩阵中删除一行一列。当删除首行首列时达到最差的情况,需要将
(n-1)^2个元素向左上移动,从而时间复杂度达到了O(n^2)。 - 初始化:传入n个顶点,初始化长度为n的顶点列表vertices,使用O(n)时间,初始化n*n大小的矩阵,使用时间O(n^2)时间。
class GraphAdjMat {
	vector<int> vertices; // 顶点列表,元素代表“顶点值”,索引代表“顶点索引”
	vector<vector<int>> adjMat; // 邻接矩阵,行列索引对应顶点索引

	public:
		GraphAdjMat(const vector<int> &vertices, const vector<vector<int>> &edges) {
			// 添加顶点
			for (int val : vertices) {
				addVertex(val);
			}

			// 添加边
			for (const vector<int> &edge : edges) {
				addEdge(edge[0], edge[1]);
			}
		}

		// 获取顶点数量
		int size() const {
			return vertices.size();
		}

		// 添加顶点
		void addVertex(int val) {
			int n = size();
			vertices.push_back(val);
			adjMat.emplace_back(vector<int>(n, 0));
			for(vector<int> &row : adjMat){
				row.push_back(0);
			}
		}

		// 删除节点
		void removeVertex(int index) {
			if(index >= size()) {
				throw out_of_range("顶点不存在");
			}

			// 在顶点列表中移除索引 index 的顶点
			vertices.erase(vertices.begin() + index);
			adjMat.erase(adjMat.begin() + index);
			for (vector<int> &row : adjMat) {
				row.erase(row.begin() + index);
			}
		}

		// 添加边
		void addEdge(int i, int j) {
			if(i < 0 || j < 0 || i >= size() || j >= size() || i == j) {
				throw out_of_range("顶点不存在");
			}
			// 在无向图中,邻接矩阵关于主对角线对称,即满足(i, j) == (j, i)
			adjMat[i][j] = 1;
			adjMat[j][i] = 1;
		}

		// 删除边
		void removeEdge(int i, int j) {
			if(i < 0 || j < 0 || i >= size() || j >= size() || i == j) {
				throw out_of_range("顶点不存在");
			}
			// 在无向图中,邻接矩阵关于主对角线对称,即满足(i, j) == (j, i)
			adjMat[i][j] = 0;
			adjMat[j][i] = 0;
		}

		void print() {
			cout << "顶点列表 = ";
        	printVector(vertices);
        	cout << "邻接矩阵 =" << endl;
        	printVectorMatrix(adjMat);
		}
}
基于邻接表的实现
设无向图的顶点总数为n、边总数为m。
- 添加边:在顶点对应链表的末尾添加边即可,使用O(1)时间。因为是无向图,所以需要同时添加两个边的方向。
- 删除边:在顶点对应链表中查找并删除指定边,使用O(m)时间,在无向图中,需要同时删除两个方向的边。
- 添加顶点:在邻接表中添加一个链表,并将新增顶点作为链表的表头,使用O(1)时间。
- 删除顶点:需遍历整个邻接表,删除包含制定顶点的所有边,使用O(n+m)时间。
- 初始化:在邻接表中创建n个顶点和2m条边,使用O(n+m)时间。
以下为邻接表的实现
- 为了方便添加与删除顶点,以及简化代码,我们使用列表(动态数组)来代替链表。
- 使用哈希表来存储邻接表,
key为顶点,value为该顶点的邻接顶点列表。
class GraphAdjList {
	public:
		unordered_map<Vertex *, vector<Vertex *>> adjList;

		void remove(vector<Vertex *> &vec, Vertex *vet) {
			for (int i = 0; i < vec.size(); i++) {
				if(vec[i] == vet) {
					vec.erase(vec.begin() + i);
					break()
				}
			}
		}

		GraphAdjList(const vector<vector<Vertex * >> &edges) {
			for(const vector<Vertex *> &edge : edges) {
				addVertex(edge[0]);
				addVertex(edge[1]);
				addEdge(edge[0], edge[1]);
			}
		}

		int size() {
			return adjList.size();
		}

		void addEdge(Vertex *vet1, Vertex *vet2) {
			if(!adjList.count(vet) || !adjList.count(vet2) || vet1 == vet2)
				throw invalid_argument("不存在顶点");
			adjList[vet1].push_back(vet2);
			adjList[vet2].push_back(vet1);
		}

		void removeEdge(Vertex *vet1, Vertex *vet2) {
			if (!adjList.count(vet1) || !adjList.count(vet2) || vet1 == vet2)
            	throw invalid_argument("不存在顶点");
			remove(adjList[vet1], vet2);
			remove(adjList[vet2], vet1);
		}

		void addVertex(Vertex *vet){
			if(adjList.count(vet))
				return;
			adjList[vet] = vector<Vertex *>();
		}

		void removeVertex(Vertex *vet) {
			if(!adjList.count(vet))
				throw invalid_argument("不存在顶点");
			adjList.erase(vet);
			for(auto &adj : adjList) {
				remove(adj.second, vet);
			}
		}
}
效率对比
| 操作 | 邻接矩阵 | 邻接表(链表) | 邻接表(哈希表) |
|---|---|---|---|
| 判断是否邻接 | O(1) | O(n) | O(1) |
| 添加边 | O(1) | O(1) | O(1) |
| 删除边 | O(1) | O(n) | O(1) |
| 添加顶点 | O(n) | O(1) | O(1) |
| 删除顶点 | O(n²) | O(n + m) | O(n) |
| 内存空间占用 | O(n²) | O(n + m) | O(n + m) |
从上表所看,似乎邻接表(哈希表)的时间效率与空间效率最优。但实际上,在邻接矩阵中操作边的效率更高,只需一次数组访问或赋值操作即可。综合来看,邻接矩阵体现了“以空间换时间”的原则,而邻接表体现了“以时间换空间”的原则。
图的遍历
树代表的是“一对多”的关系,而图具有更高的自由度——“多对多”关系。因此,我们可以把树看作图的一种特殊情况。树的遍历操作也是图的遍历的一种特殊情况。因此,图的遍历也是使用广度优先搜索和深度优先搜索算法。
广度优先遍历
广度优先搜索是一种由近到远,层层递进的遍历方式。从左上角顶点出发,首先遍历该顶点的所有邻接顶点,然后遍历下一个顶点的所有邻接顶点,以此类推,直到访问完所有的顶点为止。
vector<Vertex *> graphBFS(GraphAdjList &graph, Vertex *startVet) {
	vector<Vertex *> res; // 顶点遍历序列
	unordered_set<Vertex *> visited = {startVet}; // 哈希集合,用于记录被访问过的顶点
	// 队列用于实现BFS
	queue<Vertex *> que;
	que.push(startVet);
	while(!que.empty()) {
		Vertex *vet = que.front();
		que.pop();
		res.push_back(vet);
		for (auto adjVet : graph.adjList[vet]) {
			if (visited.count(adjVet))
				continue;
			que.push(adjVet);
			visited.emplace(adjVet);
		}
	}
	return res;
}
深度优先搜索遍历
深度优先搜索是一种优先走到底、无路可走再回头的遍历方式。从左上顶点出发,访问当前顶点的某个邻接顶点,直到走到尽头时返回,在继续走到尽头返回,以此类推,直到所有顶点都遍历完成。
void dfs(GraphAdjList &graph, unordered_set<Vertex *> &visited, vector<Vertex *> &res, Vertex *vet) {
	res.push_back(vet);
	visited.emplace(vet);
	for (Vertex *adjVet : graph.adjList[vet]) {
		if(visited.count(adjVet))
			continue;
		dfs(graph, visited, res, adjVet);
	}
}

vector<Vertex *> graphDFS(GraphAdjList &graph, Vertex *startVet) {
	vector<Vertex *> res;
	unordered_set<Vertex *> visited;
	dfs(graph, visited, res, startVet);
	return res;
}